En un experimento con 758 consultores de Boston Consulting Group, la IA los hizo terminar sus tareas 25.1% más rápido cuando la tarea caía dentro de su frontera, y los llevó a acertar 19 puntos porcentuales menos, en promedio, en una tarea que caía fuera de ella (Dell’Acqua y coautores, 2026).
La pregunta que le hago a un directivo cuando me busca por esto casi nunca es la que trae en la cabeza. Llega preguntando qué herramienta de IA comprar, o si debería restringir su uso en el equipo. La pregunta que en realidad necesita responder es otra: en su operación, tarea por tarea, ¿dónde la IA hace mejor a su gente, y dónde la hace peor sin que nadie lo note todavía?
Soy Pratosh Dwivedi, cofundador y director de tecnología de TecnIA. El supuesto que casi todos traen sin decirlo es que la capacidad de la IA crece en proporción directa a la dificultad de la tarea. No es así, y la evidencia que sigue explica por qué.
¿Qué encontró el experimento con 758 consultores de Boston Consulting Group?
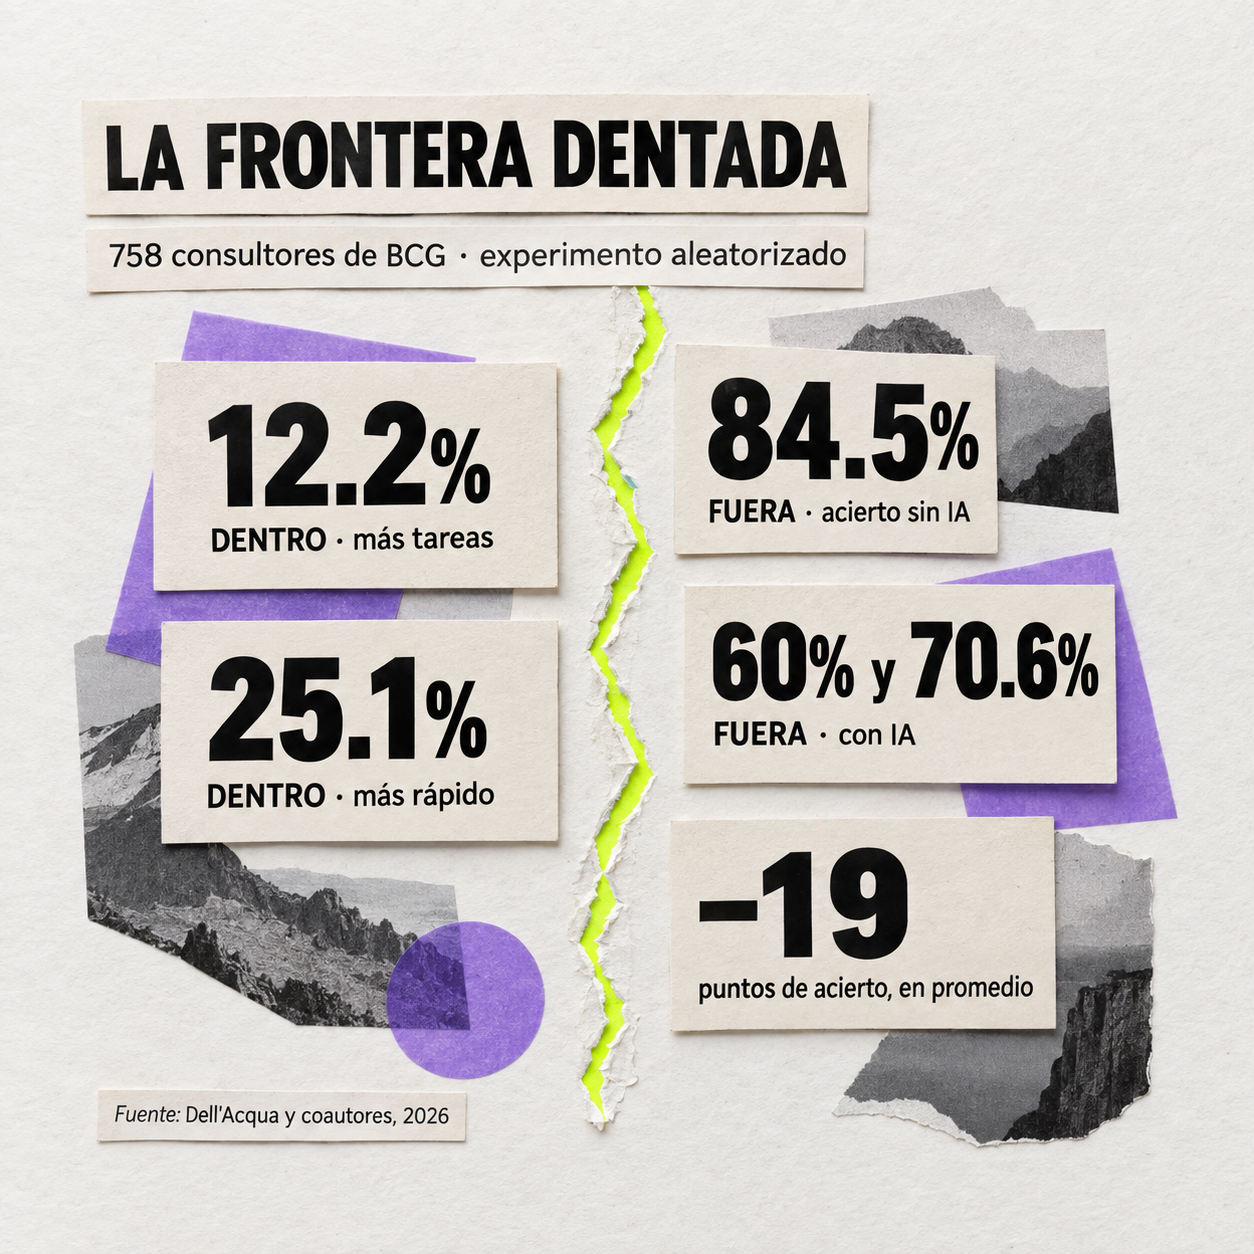
Que la misma herramienta, en el mismo flujo de trabajo, puede hacer a la gente mucho mejor en unas tareas y mucho peor en otras. El estudio de Fabrizio Dell’Acqua y ocho coautores de Harvard, Wharton, MIT y BCG asignó al azar a 758 consultores de gestión a tres condiciones: sin IA, con GPT-4, o con GPT-4 más una guía de prompts. En dieciocho tareas realistas de consultoría, dentro de lo que la IA sabía hacer bien, quienes la usaron completaron 12.2% más tareas y las resolvieron 25.1% más rápido en promedio, con una calidad de respuesta que mejoró un 32%, calificada por evaluadores humanos independientes.
El giro llega con la otra mitad del experimento. Para una tarea de recomendación estratégica de negocio, construida junto con BCG a partir del tipo de caso que la firma usa en sus propias entrevistas de contratación, el patrón se invirtió. El grupo sin IA acertó el 84.5% de las veces; los dos grupos con IA acertaron 60% y 70.6%, una caída promedio de 19 puntos porcentuales.
La tarea exigía cruzar los números de una hoja de cálculo con matices que solo aparecían en entrevistas a empleados de la empresa ficticia del caso. Tomada en conjunto, esa información llevaba a una conclusión distinta de la que arrojaba cada fuente por separado, y ahí los consultores que trabajaron con la IA se equivocaron con más frecuencia que los que no la tenían.
¿Por qué la frontera no coincide con lo que parece fácil o difícil?
Porque la capacidad de la IA no crece en proporción directa a la dificultad percibida de una tarea: sube y baja de forma desigual, como el filo de una sierra. Los propios autores llaman a esto «frontera tecnológica dentada»: tareas que a los humanos les parecen de dificultad similar pueden caer en lados opuestos de la frontera, de modo que la IA mejora el desempeño en unas mientras lo degrada en otras.
En el experimento, lo que quedó dentro de la frontera fue generar ideas de producto, segmentar un mercado, redactar un comunicado y escribir un texto persuasivo; lo que quedó afuera fue sintetizar información contradictoria de varias fuentes para tomar una decisión, cuando lo obvio resultó ser lo incorrecto. A mi juicio ese patrón se repite en otras tareas de síntesis parecidas, aunque el experimento solo puso a prueba una.
Mi lectura, y la digo como tal: ahí está la trampa para un directivo. Uno tiende a suponer que si la IA redacta bien un reporte, también va a razonar bien una decisión parecida en forma pero distinta en fondo. El estudio muestra que no hay ninguna garantía de eso, y que la sensación de dificultad de una tarea no predice de qué lado de la frontera cae.
¿Qué diferencia a quien navega bien la frontera de quien no?
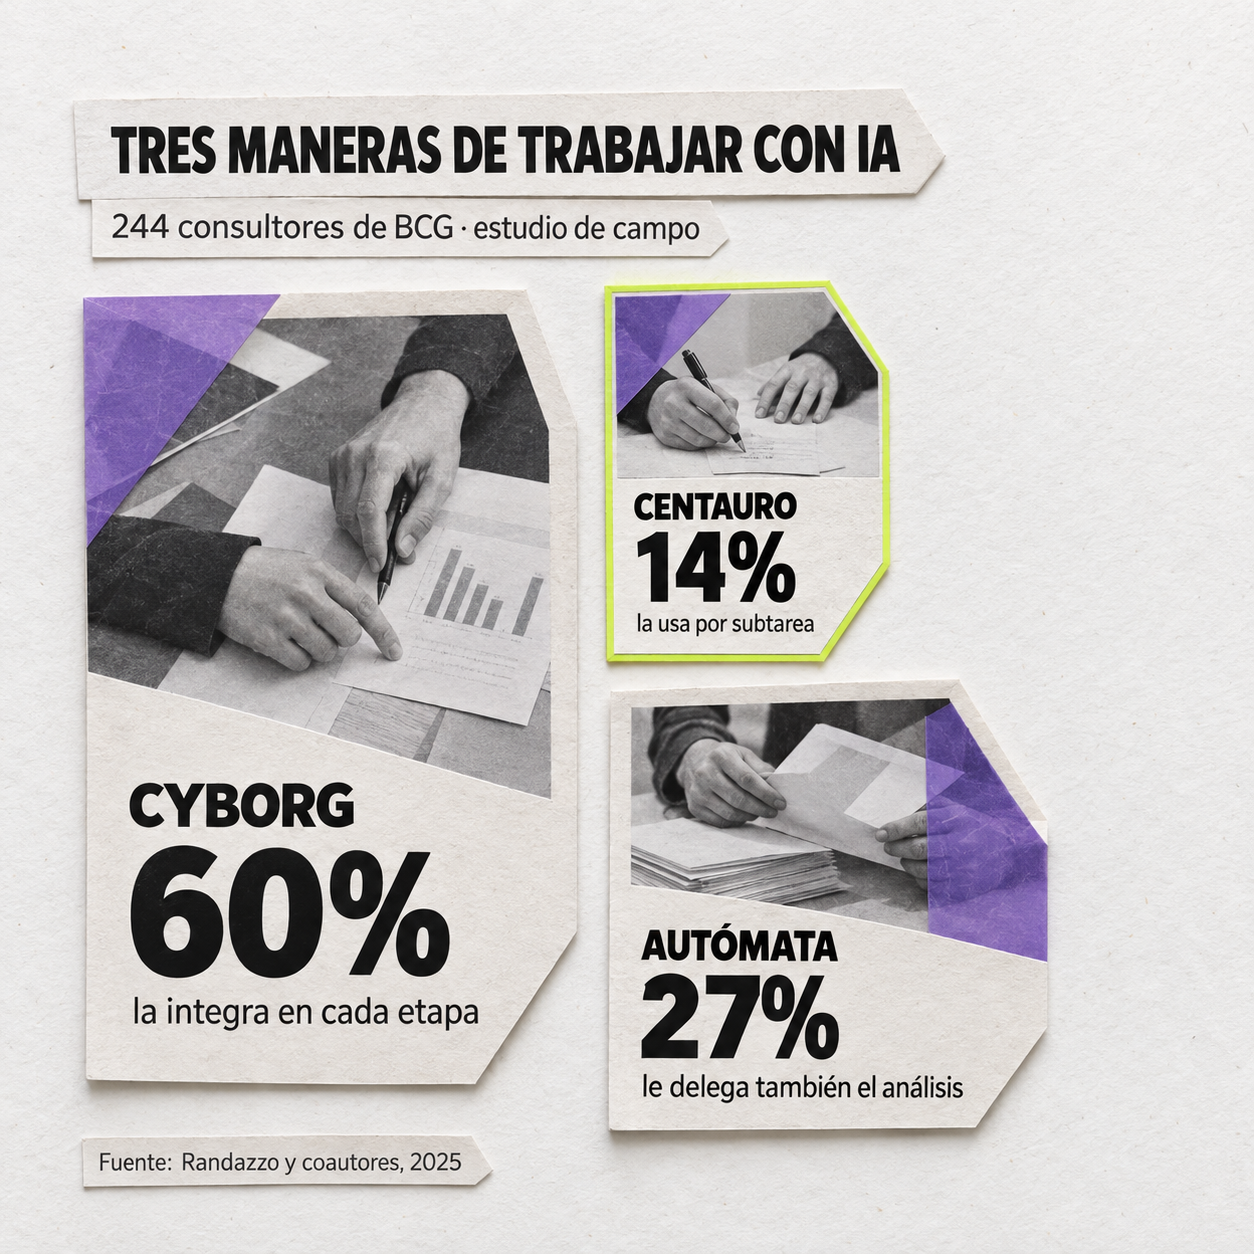
Cómo usa la IA dentro de cada tarea, no si la usa. Steven Randazzo y coautores de Warwick, MIT, Harvard y Wharton volvieron sobre esa misma tarea fuera de la frontera, la de recomendar en cuál de tres marcas de un caso ficticio invertir, y en vez de medir solo el resultado final analizaron el proceso completo: las conversaciones íntegras con GPT-4 de 244 consultores de BCG. Encontraron tres formas distintas de colaborar con la IA.
- Centauros (14%). Usan la IA por subtarea puntual y conservan el criterio del análisis completo. Ganaron más dominio de su propio tema.
- Cyborgs (60%). Integran la IA en cada etapa, en diálogo constante de preguntas y validación. Ganaron más habilidad para dirigir IA.
- Autómatas (27%). Delegan también el análisis y la evaluación. No ganaron ninguna de las dos capacidades anteriores.
La diferencia no es cosmética. Los propios autores esperan que estos modos importen sobre todo en tareas como esta, fuera de la frontera. En su estudio, quienes delegaron todo entregaron un trabajo rápido y pulido, pero sin profundidad. Mi lectura: a quien delega sin verificar justo ahí, la IA no lo hace mejor, solo le da un acabado de trabajo terminado.
¿Qué significa esto para una empresa en México, y qué hacemos en TecnIA?
Que el punto ciego no está en la herramienta: está en la revisión. No encontré una réplica de este experimento hecha con directivos mexicanos, y lo digo con esa reserva: la evidencia experimental es de una consultora global con personal reclutado internacionalmente, no una medición local.
Lo que sí hay es una encuesta de actitudes de la Universidad de Melbourne y KPMG a más de 48 mil personas en 47 países, con una muestra propia para México, y ahí aparece el mismo punto ciego desde el otro lado: 68% de quienes usan IA en su trabajo en México dice haberse apoyado en lo que la IA entregó sin evaluar si era correcto, y 53% dice haber cometido errores en su trabajo por esa razón. Y eso en un país donde 63% de la población encuestada, use o no la IA en su trabajo, dice sentir que tiene las habilidades para usarla de forma apropiada. La confianza no es el problema; la verificación, sí.
Ya escribí antes sobre la otra mitad de este mismo asunto, la brecha de habilidades de gestión que piden las vacantes más expuestas a la IA: puede leerse aquí. Lo de hoy es el paso anterior: antes de decidir quién dirige, hay que saber dónde. Esa decisión, dónde adoptar la IA y con qué criterio, es justo el terreno de nuestra maestría para directivos y negocios, que incluye la evaluación de soluciones de inteligencia artificial y el diseño de rutas de adopción tecnológica, dentro de los siete programas con Reconocimiento de Validez Oficial de Estudios de la universidad.
Si hoy tuviera que señalar una sola decisión de su equipo que la IA ya está tomando sin que nadie la verifique, ¿cuál sería? Escríbanos por WhatsApp y platicamos sin compromiso.
Preguntas frecuentes
¿El experimento de BCG se puede aplicar directamente a una empresa mexicana?
No sin cuidado. Es un experimento real y revisado por pares, pero se hizo con consultores de una firma global reclutados internacionalmente, no con directivos de una PyME mexicana. Sirve como evidencia de que la frontera dentada existe y se puede medir, no como una cifra que se traslade tal cual a cualquier empresa.
¿Cómo sé si una tarea de mi equipo está dentro o fuera de la frontera?
No hay una lista fija: la frontera se mueve con cada modelo nuevo. Los autores del experimento recomiendan mirar el flujo de trabajo completo, tarea por tarea, y evaluar en cada una qué combinación de persona e IA conviene. Mi manera de aplicarlo: en cada tarea, ponga la revisión humana justo en el borde, en el punto donde el resultado deja de ser obviamente correcto, y anote si la IA acertó o falló ahí. Esa bitácora, tarea por tarea, es el mapa real de su operación.
¿No es más simple prohibir la IA en la tarea donde falla?
Es más simple, y en el experimento con consultores de BCG salió más caro: dentro de la frontera, quienes usaron IA completaron 12.2% más tareas que quienes trabajaron sin ella, con una calidad 32% mejor en promedio. El problema no es la herramienta: es no saber en qué tarea confiar menos.
¿Qué relación tiene esto con la maestría de TecnIA para directivos?
Es un programa para profesionales, directivos y líderes de área. Según su propia ficha, incluye la evaluación de soluciones de inteligencia artificial y el diseño de rutas de adopción tecnológica: el terreno donde se toma justo el tipo de decisión que plantea este artículo.
Pratosh Dwivedi es cofundador y Director de Tecnología de TecnIA Universidad Online, donde dirige la tecnología de la universidad y su uso de la inteligencia artificial.
Este artículo fue escrito por Pratosh Dwivedi con asistencia de herramientas de inteligencia artificial, conforme a nuestra Política de IA.